Extracción masiva · Bases de datos · Análisis

Automatiza la extracción
de datos para investigación clínica.

Diseñamos algoritmos que convierten cientos de PDFs científicos o fuentes web en bases de datos estructuradas y listas para análisis. Lo que antes requería semanas de extracción manual, lo automatizamos en horas.

Ejemplo real

Extraemos todos los PDFs de PubMed sobre ensayos in vitro con un fármaco → normalizamos variables (concentración, IC₅₀, línea celular, resultado) → generamos una tabla comparativa lista para meta-análisis.

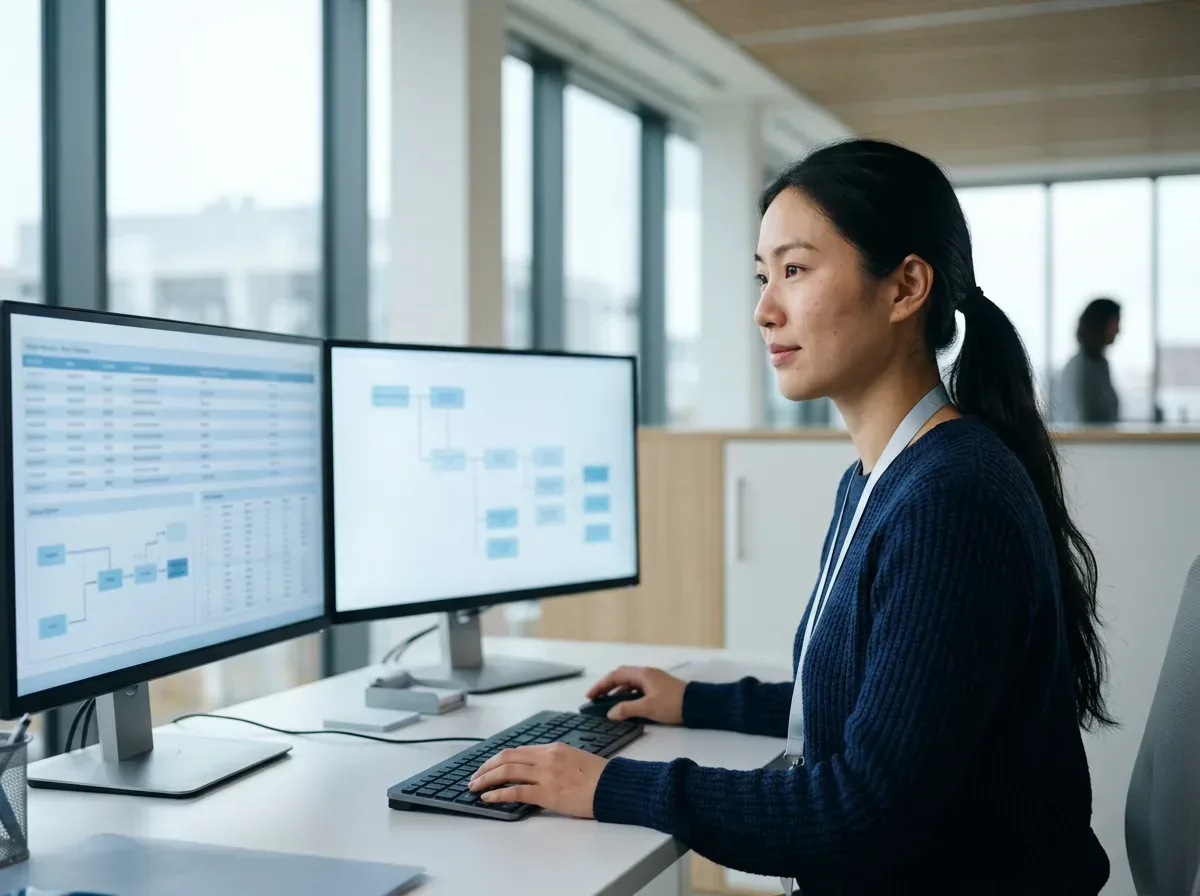
Ingeniera de datos clínicos trabajando con datos sanitarios estructurados. Imagen ilustrativa generada con IA.

Algoritmo · 5 pasos

De la pregunta al dataset

01

PubMed

Trial A · efficacy
Trial B · efficacy
Cohort · adverse

Define la pregunta

Qué datos necesitas, de qué fuentes y con qué variables.

02
Extract100%

Diseñamos el algoritmo

Agente de extracción adaptado a tu fuente: PubMed, web, PDF batch.

03
NameValueUnit
Drug A12.4mg/dL
Drug B9.8mg/dL
Drug C15.1mg/dL

Ejecutamos y validamos

Extracción masiva con control de calidad y revisión de anomalías.

04

Base de datos lista

Dataset estructurado, limpio y documentado — listo para tu análisis.

05

25/25

✓ in range

Análisis y decisiones

Visualizaciones, gráficos y dashboards sobre tus datos — de la pregunta clínica a la toma de decisiones.

PubMed · Preprints · Informes

Algoritmos de extracción desde PDFs

Automatizamos la extracción masiva de datos desde colecciones de PDFs científicos o clínicos. Cargamos cientos de artículos — por ejemplo todos los ensayos in vitro de un fármaco en PubMed — y construimos una base de datos estructurada lista para análisis estadístico.

Salida: Excel · CSV · BD
Portales · Registros · APIs públicas

Scraping estructurado de fuentes web

Extraemos datos de portales sanitarios, registros epidemiológicos y organismos regulatorios (EMA, ECDC, AEMPS, ClinicalTrials.gov) de forma sistemática y reproducible. El resultado es una base de datos actualizable, no una captura puntual.

Fuentes: HTML · JS-rendered · REST APIs

¿Qué tipo de bases de datos construimos?

Casos de uso

Respuesta corta

Diseñamos un algoritmo de extracción a medida para tu pregunta de investigación y lo ejecutamos sobre cientos de PDFs científicos o fuentes web. Recibes una base de datos estructurada, limpia y documentada, con control de calidad, trazabilidad y revisión humana, lista para tu análisis estadístico.

Preguntas frecuentes

¿Qué fuentes aceptáis?
Colecciones de PDFs científicos o clínicos, como artículos de PubMed, preprints e informes, y fuentes web: portales sanitarios, registros y APIs públicas como EMA, ECDC, AEMPS o ClinicalTrials.gov.
¿En qué formatos entregáis los datos?
Entregamos una base de datos estructurada y documentada, con salida en Excel, CSV o base de datos. En fuentes web el resultado es una base actualizable, no una captura puntual.
¿Hay revisión humana de lo extraído?
Sí. La extracción masiva pasa por control de calidad y revisión de anomalías, con trazabilidad de los datos, y el equipo valida el resultado antes de entregarte el dataset listo para análisis.
¿Cómo es el proceso de trabajo?
Defines la pregunta, las fuentes y las variables; diseñamos el algoritmo; lo ejecutamos y validamos; te entregamos la base de datos y, si lo necesitas, visualizaciones y dashboards sobre tus datos.
Extracción de datos

Extrae datos canónicos de cualquier documento clínico

De PDFs y webs a bases de datos estructuradas, con trazabilidad en cada campo.

Cuéntanos tu caso